Mein erstes RAFT-Fine-Tuning auf einer geteilten 16-GB-GPU: 7 Stolperfallen, die im Paper fehlen
Ich habe Qwen3.5 mit RAFT trainiert, damit es in der Stimme eines Creators mit geprüften Zitaten antwortet. Das Training war der leichte Teil.
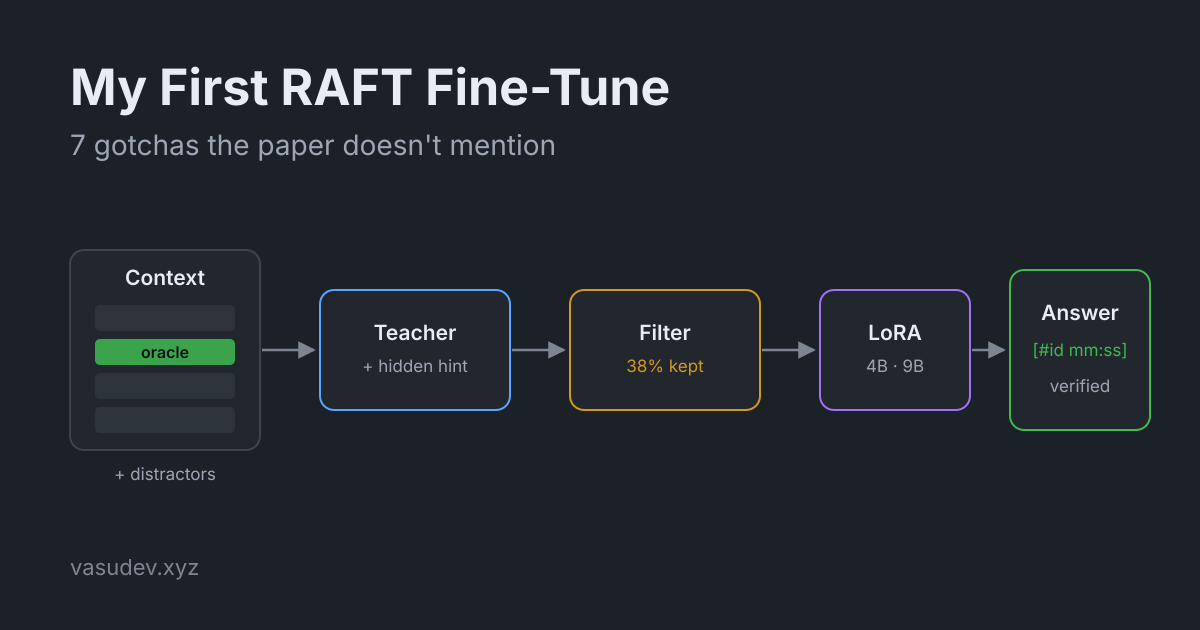
RAFT (Retrieval-Augmented Fine-Tuning) trainiert ein Modell auf Fragen mit abgerufenen Passagen, einige davon relevant, andere nur Ablenkung. So lernt es, aus der richtigen Passage zu antworten und den Rest zu ignorieren. Ich wollte das einmal von Anfang bis Ende selbst machen, um es wirklich zu verstehen, und zwar mit einem Korpus, den ich schon hatte: rund 870 Videos eines einzelnen YouTube-Creators, lokal transkribiert, überwiegend Monologe. Das Ziel war ein lokales Modell, das in der Ich-Form und mit seinen Worten antwortet, jeden Satz als [#video mm:ss] belegt und ehrlich sagt, wenn die Transkripte die Frage nicht abdecken.
Es funktioniert. Qwen3.5-4B hat auf meiner RTX 5070 Ti in unter drei Stunden trainiert, Qwen3.5-9B auf einer gemieteten 48-GB-Karte für etwa 3,50 $ Trainingszeit. Beide antworten jetzt über Open WebUI mit Zitaten, die Code gegen das Transkript geprüft hat. Auf dem Weg dahin habe ich mehr über Datenpipelines und Evaluation gelernt als über Training.
Bei RAFT ist der Trainingslauf Massenware. Über alles entscheiden der Datenfilter und die Evaluation.
1. Trainiere auf genau den Bytes, die du später auslieferst
Der häufigste Weg, ein Fine-Tuning zu verschenken, ist ein Formatunterschied. Die Trainingsbeispiele nutzen einen System-Prompt und ein Passagenlayout, der Inferenzcode ein leicht anderes. Das Modell sieht dann im Betrieb Eingaben, auf die es nie trainiert wurde, und die Verbesserungen verschwinden still und leise.
Die Lösung ist strukturell, keine Frage der Disziplin. Eine einzige Funktion baut den Prompt, und sowohl der Datengenerator als auch die Antwortpipeline rufen sie auf:
def prompt(passages: list[Passage], question: str) -> tuple[dict, str, str]:
    """(passages by id S1..Sn, system prompt, user message). Training examples are built with this too, so
    the fine-tuned model sees exactly the inference format."""
    sources = {f"S{n}": p for n, p in enumerate(passages, 1)}
    blocks = [_passage_block(p, label) for label, p in sources.items()] or ["(no passages found)"]
    return sources, SYSTEM, "\n\n".join(blocks) + "\n\n" + TASK + question
Auch der Kontext jedes Trainingsbeispiels kommt aus demselben laufenden Retrieval-Dienst wie im Chat, mit demselben k. Das Schülermodell sieht nie ein Passagenlayout, eine Rangfolge oder eine Kontextlänge, die die Inferenz nicht auch erzeugt.
Lektion: Wenn Training und Betrieb ihre Prompts an zwei Stellen bauen, laufen sie auseinander. Mach eine Funktion daraus.
2. Der Lehrer bekommt einen Hinweis, den der Schüler nie sieht
RAFT braucht zwei Arten von Beispielen. Im Oracle-Fall steht die Passage, aus der die Frage stammt, irgendwo im Kontext zwischen Ablenkungspassagen. Im reinen Ablenkungsfall ist jede Passage aus diesem Video entfernt, und die richtige Antwort lautet oft, dass die Transkripte das nicht abdecken.
Die Antworten habe ich von einem lokalen Lehrermodell destilliert, qwen3.5:9b. Sich selbst überlassen, antwortet der Lehrer aus der Passage, die am ähnlichsten aussieht, und enthält sich fast nie. Deshalb bekommt er eine zusätzliche Zeile, die nie in den Trainingsdaten landet:
HINT_ORACLE = ("Hint (not shown at inference): passage {label} is where this question came from; build the answer "
               "mainly from his words there. " + VOICE)
Der Hinweis im Ablenkungsfall sagt das Gegenteil: Keine dieser Passagen war die Quelle, antworte nur, wenn sie die Frage wirklich abdecken, sonst enthalte dich in seiner Stimme. Die Oracle-Passage landet an einer zufälligen Position unter den besten k-1 Treffern, damit der Schüler nicht lernt, dass die Antwort immer vorne steht. 80 % der Versuche sind Oracle-Fälle, der Rest reine Ablenkung, und die Generierung läuft weiter, bis mindestens 12 % der behaltenen Beispiele Enthaltungen sind.
Lektion: Der Lehrer darf beim Generieren Dinge wissen, die der Schüler erschließen lernen muss. Nutze diese Asymmetrie und entferne den Hinweis aus dem, was du speicherst.
3. Filtern ist die eigentliche Arbeit: Ich habe 38 % behalten
Der Lehrer hat 7.988 Versuche gemacht. 3.012 haben überlebt. Die Gründe fürs Aussortieren zeigen gut, was ein 9B-Lehrer mit einem strengen Format anstellt:
| Grund | Aussortiert |
|---|---|
| Satz ohne Zitat | 1.569 |
| zu wenig wörtliche Formulierungen aus der Passage | 1.019 |
| formelhafte Enthaltung („I haven’t talked about“) | 875 |
| Zitat nicht in der Passage gefunden | 513 |
| Marker ohne zugehöriges Zitat | 393 |
Jeder Filter existiert, weil eine frühe Stichprobe den Fehler gezeigt hat. Der hinterhältigste ist das falsche Abstreiten: In einem Oracle-Beispiel steht die Antwort im Kontext, trotzdem beginnt der Lehrer mit „I haven’t talked about that“ und antwortet dann doch. Trainierst du darauf, lernt der Schüler, Dinge abzustreiten, die er weiß. Ein regulärer Ausdruck erkennt den Anfang, und diese Beispiele fliegen auch beim Export raus:
FALSE_DENIAL = re.compile(  # an oracle answer opening with a denial although the source passage is in context
    r"^(?:\w+,\s+)?I(?: (?:(?:haven[’']t|have not|have never|never|don[’']t|do not|didn[’']t) (?:talk|talked|say|"
    r"said|discuss|discussed|cover|covered|mention|mentioned)\b|haven[’']t \w+)|[’']ve (?:never|not) \w+)")
Jeder Aussortiergrund wird in einem Datenblatt neben den Daten gezählt, zusammen mit den Themenanteilen, den häufigsten Antwortanfängen und 20 zufälligen Beispielen. Als „I haven’t talked“ 189-mal als Anfang auftauchte, war das das Signal für den Filter gegen formelhafte Enthaltungen.
Lektion: Eine Rejection-Sampling-Pipeline mit gezählten Aussortiergründen ist mehr wert als jeder Hyperparameter. Lies das Datenblatt, bevor du trainierst.
4. Lass das Modell nie Zeitstempel schreiben
Ein Modell, das [#470 00:04] selbst schreibt, erfindet irgendwann einen plausiblen Zeitstempel. Deshalb sieht das Modell gar keine Zeitstempel. Es zitiert Passagen-IDs wie [S3] und dazu jeweils ein wörtliches Zitat von 8 bis 40 Wörtern. Code sucht das Zitat dann im Transkript, ordnet es Zeitstempeln auf Wortebene zu und schreibt den Marker um:
fit = fit_quote(p, str(c.get("quote", "")).strip()) if p else None
span = quote_span(p, fit[0]) if fit else None
if not span:
    invalid += 1                      # marker gets removed from the answer
    refs.setdefault(label, []).append(None)
    continue
refs.setdefault(label, []).append(f"#{p.doc.file_id} {clock(span[0])}")
Die Gültigkeit der Zitate liegt damit konstruktionsbedingt bei 1,00. Jeder Zeitstempel in einer Antwort zeigt auf Wörter, die wirklich dort stehen.
Der Haken kam, als ich mit dem Modell chatten wollte. Das rohe Modell liefert JSON mit [S3]-Platzhaltern, das ist in einer Chat-Oberfläche nutzlos. Also habe ich einen kleinen OpenAI-kompatiblen Server geschrieben, der pro Nachricht Retrieval, Modell und Prüfung ausführt und Markdown zurückgibt, in dem die Marker auf YouTube verlinken. Open WebUI zeigte daraufhin einen „not found“-Fehler. Die neue Verbindung stand auf der Responses-API und rief POST /v1/responses auf. Die Umstellung auf Chat Completions hat es behoben.
Lektion: Leg die Fakten, die das Modell falsch machen kann (IDs, Zeitstempel, URLs), in den Code und lass das Modell nur zwischen Optionen wählen, die du prüfen kannst.
5. Datenlecks sind ein Datenproblem, also prüfe sie auch so
Eine Evaluation ist nur etwas wert, wenn keine Eval-Folge ins Training rutscht. Jedes Video, auf das sich eine Eval-Antwort stützt, kommt in ein Holdout-Set. Videos mit mehreren Sprechern (Interviews, Anrufe) sind komplett ausgeschlossen, weil die Transkripte keine Sprecherkennung haben und die Ansichten des Gastes sonst in seiner Stimme landen würden. Der Filter läuft bei der Generierung und noch einmal beim Export, denn das Holdout kann wachsen, nachdem Beispiele schon existieren:
def usable(examples: list[dict], holdout: set) -> list[dict]:
    return [e for e in examples if not false_denial(e) and e["meta"]["context"] and e["meta"]["file_id"] not in holdout
            and not {x["file_id"] for x in e["meta"]["context"] + e["meta"]["retrieved"]} & holdout]
Wichtig ist die letzte Zeile: Nicht nur das Quellvideo, sondern jede Passage im Kontext muss außerhalb des Holdouts liegen. Bevor ich irgendetwas auf eine Cloud-GPU hochgeladen habe, lief ein separates Skript über die fertigen train.jsonl und val.jsonl und ordnete jede Passage ihrer Datei zu: null Treffer aus den 113 Holdout-Folgen, null aus Videos mit mehreren Sprechern.
Lektion: Prüfe die exportierte Datei selbst, nicht nur den Code, der sie erzeugen sollte.
6. RAFT hat Stil gebracht, keine Fakten
Dieselben 129 Fragen, identisches Retrieval für jedes Modell (hit@10 0,738), bewertet von qwen3.5:9b:
| Kennzahl | RAFT-9B | Basis-9B | RAFT-4B | Basis-4B |
|---|---|---|---|---|
| belegt (von 103 beantwortbaren) | 69 % | 69 % | 64 % | 64 % |
| Kernpunkt-Abdeckung | 0,50 | 0,46 | 0,48 | 0,44 |
| Zitat-Präzision | 0,63 | 0,55 | 0,63 | 0,61 |
| korrekte Enthaltung (26 unbeantwortbare) | 0,92 | 0,85 | 0,85 | 0,85 |
| falsche Enthaltung | 5,8 % | 2,9 % | 9,7 % | 2,9 % |
| wörtlicher Anteil | 0,57 | 0,35 | 0,60 | 0,20 |
| Stil (1 bis 5) | 3,66 | 2,36 | 3,80 | 2,09 |
Die Belegquote hat sich nicht bewegt. Die Stimme sehr. Der wörtliche Anteil hat sich beim 4B fast verdreifacht, und die Stilnote ging von „generischer Assistent“ zu „erkennbar er“. Beim 9B haben sich Abdeckung, Zitat-Präzision und korrekte Enthaltung leicht verbessert.
Der Preis ist die falsche Enthaltung: RAFT sagt öfter „dazu habe ich nichts gesagt“ als die Basis. Ich habe jeden Fall geprüft. Beim 9B waren 5 der 6 falschen Enthaltungen Fragen, bei denen das Retrieval die Antwort gar nicht gefunden hatte (hit@10 = 0). Sich zu enthalten war bei diesem Kontext die ehrliche Antwort. Nur ein Fall war ein echter Verlust. Und die größere 9B-Basis schlägt bei der Belegquote immer noch beide 4B-Modelle, was mehr über Parameter aussagt als jedes LoRA.
Einen Vorbehalt kann ich nicht billig beheben: Der Bewerter ist dasselbe Modell wie der Lehrer und mag deshalb Antworten, die nach ihm selbst klingen. Der wörtliche Anteil wird im Code berechnet, hat diese Verzerrung nicht und erzählt dieselbe Geschichte.
Lektion: Trenne in deiner Evaluation „was weiß es“ von „wie sagt es das“, sonst sieht ein Stilgewinn aus wie ein Wissensgewinn.
7. Cloud-GPUs scheitern auf langweilige Art
Das 9B-Modell braucht etwa 25 GB für BF16-LoRA-Training, deshalb lief es in der Secure Cloud von RunPod. Mein erster Pod hat PyTorch 18 Minuten lang mit 140 KB/s geladen, bevor ich ihn gelöscht habe. Der zweite, eine RTX 6000 Ada für 0,99 $/h, hat in 3 h 35 min auf einen Eval-Loss von 0,139 trainiert (4B: 0,190).
Dann hat mein nächtlicher Watcher das Ende verpasst. Er hat den Pod per SSH abgefragt und ist zur nächsten Runde gesprungen, sobald SSH fehlschlug:
st=$(ssh "$POD" 'pgrep -f "^bash runpod_9b.sh" && echo RUNNING;
      grep -qE "Traceback|Error:" run.log && echo ERROR') || { sleep 120; continue; }
Der Exit-Status des entfernten Befehls ist der des letzten grep, und der ist 1, wann immer das Log keinen Fehler enthält. Jede gesunde Prüfung zählte also als fehlgeschlagene Verbindung, und der Pod stand drei Stunden untätig herum, bis ein Deadline-Skript ihn stoppte. Ein ; true am Ende des entfernten Befehls behebt das.
Die zweite Überraschung: Ein gestoppter Pod behält sein Volume auf dem physischen Host, und der Neustart braucht eine freie GPU auf genau diesem Host. Bis in den frühen Morgen gab es keine, das fertige Modell war stundenlang unerreichbar. Beim nächsten Mal schiebt der Job seine Ergebnisse als letzten Schritt selbst irgendwohin, statt darauf zu warten, abgeholt zu werden.
Lektion: Schreib bei unbeaufsichtigten Cloud-Jobs den Watcher so sorgfältig wie das Trainingsskript und teste ihn vorher gegen einen vorgetäuschten Fertig-Zustand.
Was ich weggelassen habe
- Ein unabhängiger Bewerter. Wenn der Lehrer seinen eigenen Schüler bewertet, schmeichelt das dem Stil. Eine andere Modellfamilie als Bewerter ist der naheliegende nächste Schritt.
- Prüfen, ob ein Zitat die Aussage stützt. Der Code prüft, dass ein Zitat wörtlich existiert, nicht dass es den Satz belegt, an dem es hängt. Die Zitat-Präzision von 0,63 ist die ehrliche Zahl für diese Lücke.
- Training über mehrere Gesprächsrunden. Jedes Beispiel ist eine einzelne Frage. Bei einer kurzen Nachfrage wie „warum?“ stellt der Chat-Server die vorige Frage voran. Das ist ein Behelf, keine Fähigkeit.
- Training von Retriever und Reranker. Der Export schreibt schon Paare aus Anfrage, Passage und schwierigen Gegenbeispielen. Bei hit@10 von 0,738 landet bei einem Viertel der Fragen die richtige Passage nie im Kontext, dort liegt der nächste echte Gewinn.
- Präferenz-Training gegen falsche Enthaltung. DPO-Paare aus „enthalten, obwohl die Antwort im Kontext stand“ und „beantwortet“ würden genau die Verschlechterung aus Stolperfalle 6 angehen.
Der Aufbau
Alles außer dem 9B-Training lief auf einem Desktop-Rechner: einer RTX 5070 Ti (16 GB), die ich über ein kleines Lease-Tool mit anderen Jobs teile. Datengenerierung, Training und Evaluationen haben sich so für den Grafikspeicher angestellt, statt sich gegenseitig abstürzen zu lassen. Das 4B-Training nutzte BF16-LoRA mit Rang 16 auf 200 Modulen, 2 Epochen, 358 Schritte und höchstens 10,8 GB. Die Modelle werden als GGUF Q4_K_M exportiert und von Ollama ausgeliefert. Kein Transkript hat den Rechner verlassen, außer dem Trainingspaket für die gemietete GPU, und das wurde mit dem Pod gelöscht.
Wenn du RAFT ausprobieren willst, fang mit Stolperfalle 3 an: Bau den Aussortierfilter und das Datenblatt, bevor du eine einzige Zeile Trainingscode schreibst. Dort habe ich die meiste Zeit verbracht, und genau dort hat es sich gelohnt. Die Schritt-für-Schritt-Fassung mit Standardwerten und Checkliste ist der RAFT Fine-Tuning Guide.
Christian Pojoni baut lokale KI-Systeme und schreibt darüber, was dabei kaputtgeht. Mehr auf vasudev.xyz.
Mehr aus dem Blog
Capital‑of ist kein einzelnes SAE‑Feature. Also habe ich eine Mutationsschleife gebaut, um herauszufinden, was es ist.
SAE‑Funktionen können Beziehungen in Gemma-2-2B nicht isolieren. Ich habe eine Mutations‑Auswahl‑Schleife gebaut, die das kann. Der Engpass war die Tokenisierung.
Hör auf, dein KI‑System zu entwerfen. Entwirf seine Umgebung.
Selbstentwickelnde KI‑Systeme scheitern, wenn sie einen festen Evaluator optimieren. Das biologische Modell ist richtig: Was sich entwickeln muss, ist der Selektionsdruck, nicht nur das Genom.
Die Speicherkennzahlen Ihres Agenten täuschen Sie. So können Sie sie verankern.
Gedächtniskonsolidierung sieht in Dashboards großartig aus. Aber wenn sich Ihre Metriken verbessern können, ohne dass der Abruf besser wird, optimieren Sie einen abgekoppelten Proxy.
Kommentare