Mi primer fine-tuning con RAFT en una GPU compartida de 16 GB: 7 trampas que el paper no menciona
Ajusté Qwen3.5 con RAFT para que responda con la voz de un creador y citas verificadas. El entrenamiento fue la parte fácil.
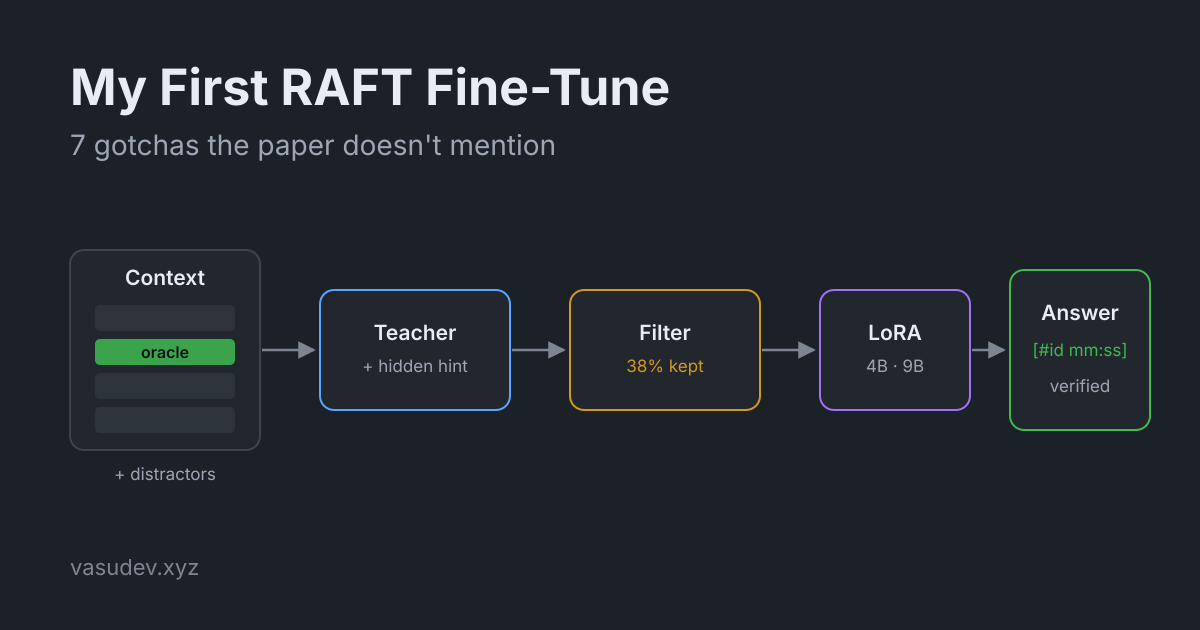
RAFT (Retrieval-Augmented Fine-Tuning) entrena un modelo con preguntas acompañadas de pasajes recuperados, algunos relevantes y otros solo distractores, para que aprenda a responder desde el pasaje correcto e ignorar el resto. Quería entenderlo haciéndolo una vez de principio a fin, con un corpus que ya tenía: unos 870 vídeos de un único creador de YouTube, transcritos en local, casi todos monólogos. El objetivo era un modelo local que responda en primera persona, con sus propias palabras, que cite cada frase como [#video mm:ss] y que diga con honestidad cuándo las transcripciones no cubren la pregunta.
Funciona. Qwen3.5-4B se entrenó en mi RTX 5070 Ti en menos de tres horas, y Qwen3.5-9B en una tarjeta alquilada de 48 GB por unos 3,50 $ de tiempo de entrenamiento. Los dos responden ahora a través de Open WebUI con citas que el código ha comprobado contra la transcripción. Por el camino aprendí más sobre pipelines de datos y evaluación que sobre entrenamiento.
En RAFT, el entrenamiento es lo de menos. El filtro de datos y la evaluación lo deciden todo.
1. Entrena exactamente con los bytes que vas a servir
La forma más común de desperdiciar un fine-tuning es un desajuste de formato. Los ejemplos de entrenamiento usan un prompt de sistema y una disposición de pasajes, y el código de inferencia usa otra ligeramente distinta. El modelo ve entonces en producción una distribución de entradas con la que nunca entrenó, y las mejoras se evaporan sin hacer ruido.
La solución es estructural, no una cuestión de disciplina. Una sola función construye el prompt, y tanto el generador de datos como el pipeline de respuestas la llaman:
def prompt(passages: list[Passage], question: str) -> tuple[dict, str, str]:
    """(passages by id S1..Sn, system prompt, user message). Training examples are built with this too, so
    the fine-tuned model sees exactly the inference format."""
    sources = {f"S{n}": p for n, p in enumerate(passages, 1)}
    blocks = [_passage_block(p, label) for label, p in sources.items()] or ["(no passages found)"]
    return sources, SYSTEM, "\n\n".join(blocks) + "\n\n" + TASK + question
El contexto de cada ejemplo de entrenamiento también sale del mismo servicio de recuperación que usa el chat, con el mismo k. El modelo alumno nunca ve una disposición de pasajes, un orden o una longitud de contexto que la inferencia no vaya a producir.
Lección: si el entrenamiento y el servicio construyen los prompts en dos sitios, acabarán divergiendo. Haz de ello una sola función.
2. El maestro recibe una pista que el alumno nunca ve
RAFT necesita dos tipos de ejemplos. En el caso oráculo, el pasaje del que salió la pregunta está en algún lugar del contexto, entre distractores. En el caso de solo distractores, se elimina cualquier pasaje de ese vídeo, y la respuesta correcta suele ser que las transcripciones no lo cubren.
Destilé las respuestas de un modelo maestro local, qwen3.5:9b. Si se le deja solo, el maestro responde desde el pasaje que parece más cercano y casi nunca se abstiene. Por eso recibe una línea extra que nunca se guarda en los datos de entrenamiento:
HINT_ORACLE = ("Hint (not shown at inference): passage {label} is where this question came from; build the answer "
               "mainly from his words there. " + VOICE)
La pista del caso con distractores dice lo contrario: ninguno de estos pasajes era la fuente, responde solo si de verdad cubren la pregunta y, si no, abstente con su voz. El pasaje oráculo va a una posición aleatoria entre los mejores k-1 resultados, para que el alumno no aprenda que la respuesta siempre va primero. El 80 % de los intentos son casos oráculo y el resto solo distractores, y la generación continúa hasta que al menos el 12 % de los ejemplos guardados son abstenciones.
Lección: el maestro puede saber cosas al generar que el alumno tiene que aprender a deducir. Aprovecha esa asimetría y quita la pista de lo que guardas.
3. Filtrar es el trabajo de verdad: me quedé con el 38 %
El maestro hizo 7.988 intentos. Sobrevivieron 3.012. Los motivos de descarte dicen mucho de lo que hace un maestro de 9B con un formato estricto:
| Motivo | Descartes |
|---|---|
| frase sin cita | 1.569 |
| muy poca redacción literal del pasaje | 1.019 |
| abstención formularia («I haven’t talked about») | 875 |
| cita que no aparece en el pasaje | 513 |
| marcador que no apunta a ninguna cita | 393 |
Cada filtro existe porque una muestra temprana mostró el fallo. El más traicionero es la falsa negación: en un ejemplo oráculo la respuesta está en el contexto, pero el maestro empieza con «I haven’t talked about that» y luego responde igualmente. Si entrenas con eso, el alumno aprende a negar lo que sabe. Una expresión regular detecta el comienzo, y esos ejemplos también se descartan en la exportación:
FALSE_DENIAL = re.compile(  # an oracle answer opening with a denial although the source passage is in context
    r"^(?:\w+,\s+)?I(?: (?:(?:haven[’']t|have not|have never|never|don[’']t|do not|didn[’']t) (?:talk|talked|say|"
    r"said|discuss|discussed|cover|covered|mention|mentioned)\b|haven[’']t \w+)|[’']ve (?:never|not) \w+)")
Cada motivo de descarte se cuenta en una hoja de datos junto a los datos, con el reparto por temas, los comienzos de respuesta más frecuentes y 20 ejemplos aleatorios. Cuando «I haven’t talked» apareció 189 veces como comienzo, esa fue la señal para añadir el filtro de abstenciones formularias.
Lección: un pipeline de muestreo por rechazo con los motivos de descarte contados vale más que cualquier hiperparámetro. Lee la hoja de datos antes de entrenar.
4. Nunca dejes que el modelo escriba marcas de tiempo
Un modelo que escribe [#470 00:04] por sí mismo acabará inventando una marca de tiempo verosímil. Por eso el modelo nunca ve marcas de tiempo. Cita identificadores de pasaje como [S3] y, para cada uno, una cita literal de 8 a 40 palabras. Luego el código busca la cita en la transcripción, la asigna a marcas de tiempo a nivel de palabra y reescribe el marcador:
fit = fit_quote(p, str(c.get("quote", "")).strip()) if p else None
span = quote_span(p, fit[0]) if fit else None
if not span:
    invalid += 1                      # marker gets removed from the answer
    refs.setdefault(label, []).append(None)
    continue
refs.setdefault(label, []).append(f"#{p.doc.file_id} {clock(span[0])}")
La validez de las citas es por tanto 1,00 por construcción. Cada marca de tiempo de una respuesta apunta a palabras que de verdad están ahí.
La pega apareció cuando quise chatear con él. El modelo en bruto devuelve JSON con marcadores [S3], algo inútil en una interfaz de chat, así que escribí un pequeño servidor compatible con OpenAI que ejecuta recuperación, modelo y validación en cada mensaje y devuelve markdown con los marcadores enlazados a YouTube. Open WebUI mostró entonces un error «not found». La nueva conexión estaba configurada con la Responses API y llamaba a POST /v1/responses. Cambiar la conexión a Chat Completions lo arregló.
Lección: pon en el código los datos en los que el modelo puede equivocarse (identificadores, marcas de tiempo, URLs) y deja que el modelo elija solo entre opciones que puedas comprobar.
5. Las fugas son un problema de datos, así que compruébalas como tal
Una evaluación solo vale algo si ningún episodio de evaluación se cuela en el entrenamiento. Cada vídeo al que hace referencia una respuesta de evaluación va a un conjunto reservado. Los vídeos con varios hablantes (entrevistas, llamadas) se excluyen por completo, porque las transcripciones no distinguen hablantes y las opiniones del invitado acabarían en su voz. El filtro se aplica al generar y otra vez al exportar, porque el conjunto reservado puede crecer cuando ya existen ejemplos:
def usable(examples: list[dict], holdout: set) -> list[dict]:
    return [e for e in examples if not false_denial(e) and e["meta"]["context"] and e["meta"]["file_id"] not in holdout
            and not {x["file_id"] for x in e["meta"]["context"] + e["meta"]["retrieved"]} & holdout]
Fíjate en la última línea: no solo el vídeo de origen, sino cada pasaje del contexto debe quedar fuera del conjunto reservado. Antes de subir nada a una GPU en la nube, un script independiente recorrió los train.jsonl y val.jsonl finales y asignó cada pasaje a su archivo: cero coincidencias de los 113 episodios reservados y cero de vídeos con varios hablantes.
Lección: comprueba el archivo exportado, no solo el código que se suponía que debía generarlo.
6. RAFT compró estilo, no hechos
Las mismas 129 preguntas, recuperación idéntica para cada modelo (hit@10 de 0,738) y evaluación con qwen3.5:9b:
| Métrica | RAFT-9B | Base-9B | RAFT-4B | Base-4B |
|---|---|---|---|---|
| respaldadas (de 103 con respuesta) | 69 % | 69 % | 64 % | 64 % |
| cobertura de puntos clave | 0,50 | 0,46 | 0,48 | 0,44 |
| precisión de citas | 0,63 | 0,55 | 0,63 | 0,61 |
| abstención correcta (26 sin respuesta) | 0,92 | 0,85 | 0,85 | 0,85 |
| abstención errónea | 5,8 % | 2,9 % | 9,7 % | 2,9 % |
| proporción literal | 0,57 | 0,35 | 0,60 | 0,20 |
| estilo (1 a 5) | 3,66 | 2,36 | 3,80 | 2,09 |
El respaldo factual no se movió. La voz, muchísimo. La proporción literal casi se triplicó en el 4B y la nota de estilo pasó de «asistente genérico» a «se le reconoce». En el 9B, la cobertura, la precisión de citas y la abstención correcta mejoraron un poco.
El precio es la abstención errónea: RAFT dice «de eso no he hablado» más a menudo que la base. Revisé cada caso. En el 9B, 5 de las 6 abstenciones erróneas eran preguntas en las que la recuperación no había encontrado la respuesta (hit@10 = 0), así que abstenerse era la respuesta honesta a ese contexto. Solo uno fue una pérdida real. Y la base de 9B, más grande, sigue superando a los dos modelos de 4B en respaldo, lo que dice más de los parámetros que cualquier LoRA.
Hay una salvedad que no puedo resolver barato: el evaluador es el mismo modelo que el maestro, así que le gustan las respuestas que suenan como las suyas. La proporción literal se calcula en el código, no tiene ese sesgo y cuenta la misma historia.
Lección: separa en tu evaluación «qué sabe» de «cómo lo dice», o una mejora de estilo parecerá una mejora de conocimiento.
7. Las GPUs en la nube fallan de formas aburridas
El modelo de 9B necesita unos 25 GB para entrenar LoRA en BF16, así que se ejecutó en el Secure Cloud de RunPod. Mi primer pod descargó PyTorch a 140 KB/s durante 18 minutos antes de que lo borrara. El segundo, una RTX 6000 Ada a 0,99 $/h, entrenó en 3 h 35 min hasta una pérdida de evaluación de 0,139 (4B: 0,190).
Después, mi vigilante nocturno se perdió el final. Consultaba el pod por SSH y saltaba a la siguiente ronda cada vez que SSH fallaba:
st=$(ssh "$POD" 'pgrep -f "^bash runpod_9b.sh" && echo RUNNING;
      grep -qE "Traceback|Error:" run.log && echo ERROR') || { sleep 120; continue; }
El código de salida del comando remoto es el del último grep, que vale 1 siempre que el log no tiene errores. Así que cada comprobación sana contaba como una conexión fallida, y el pod estuvo parado tres horas hasta que un script con fecha límite lo detuvo. Terminar el comando remoto con ; true lo arregla.
La segunda sorpresa: un pod detenido conserva su volumen en el host físico, y reiniciarlo requiere una GPU libre en ese mismo host. No hubo ninguna hasta la madrugada, así que el modelo terminado estuvo fuera de alcance durante horas. La próxima vez, el trabajo enviará sus resultados a otro sitio como último paso en lugar de esperar a que alguien los recoja.
Lección: en trabajos en la nube sin supervisión, escribe el vigilante con tanto cuidado como el script de entrenamiento y pruébalo antes con un estado «terminado» simulado.
Lo que dejé fuera
- Un evaluador independiente. Que el maestro evalúe a su propio alumno favorece el estilo. Un evaluador de otra familia de modelos es el siguiente paso obvio.
- Comprobar que una cita respalda la afirmación. El código verifica que una cita existe literalmente, no que respalde la frase a la que va unida. La precisión de citas de 0,63 es la cifra honesta de ese hueco.
- Entrenamiento con varios turnos. Cada ejemplo es una sola pregunta. Ante una repregunta corta como «¿por qué?», el servidor de chat antepone la pregunta anterior. Es un apaño, no una habilidad.
- Entrenamiento del recuperador y del reranker. La exportación ya escribe pares de consulta, pasaje y negativos difíciles. Con un hit@10 de 0,738, una cuarta parte de las preguntas nunca recibe el pasaje correcto en el contexto, así que ahí está la siguiente mejora real.
- Ajuste por preferencias contra la abstención errónea. Pares DPO de «se abstuvo con la respuesta en el contexto» frente a «respondió» atacarían justo el retroceso de la trampa 6.
La configuración
Todo salvo el entrenamiento de 9B se ejecutó en un único equipo de escritorio: una RTX 5070 Ti (16 GB) compartida con otros trabajos mediante una pequeña herramienta de reservas, así que la generación de datos, el entrenamiento y las evaluaciones hacían cola para la VRAM en lugar de tumbarse entre sí. El entrenamiento de 4B usó LoRA en BF16 con rango 16 sobre 200 módulos, 2 épocas, 358 pasos y un pico de 10,8 GB. Los modelos se exportan a GGUF Q4_K_M y los sirve Ollama. Ninguna transcripción salió de la máquina, salvo el paquete de entrenamiento para la GPU alquilada, que se borró junto con el pod.
Si quieres probar RAFT, empieza por la trampa 3: construye el filtro de rechazo y la hoja de datos antes de escribir una sola línea de código de entrenamiento. Ahí pasé la mayor parte del tiempo, y era la parte en la que merecía la pena pasarlo. La versión paso a paso, con valores por defecto y una lista de comprobación, es la RAFT Fine-Tuning Guide.
Christian Pojoni construye sistemas de IA locales y escribe sobre lo que se rompe. Más en vasudev.xyz.
Más artículos del blog
Capital-of no es una sola característica SAE. Así que construí un bucle de mutación para averiguar qué es.
Las características de SAE no pueden aislar relaciones en Gemma-2-2B. Construí un bucle de mutación‑selección que sí puede. El cuello de botella era la tokenización.
Deja de diseñar tu sistema de IA. Diseña su entorno.
Los harnesses de IA autoevolutiva fallan cuando optimizan un evaluador fijo. El modelo biológico tiene razón: lo que necesita evolucionar es la presión de selección, no solo el genoma.
Las métricas de memoria de tu agente te están mintiendo. Así es como puedes fundamentarlas.
La consolidación de la memoria luce genial en los paneles de control. Pero si tus métricas pueden mejorar sin que la recuperación mejore, estás optimizando un proxy desacoplado.
Comentarios